Od wyzwania biznesowego do działającego rozwiązania AI
Przejrzysty proces Data Science i AI, który prowadzi do mierzalnych efektów
Od pierwszej konsultacji i audytu danych, przez iteracyjne modelowanie, aż po wdrożenie i stały monitoring — każdy etap łączymy z konkretnym celem biznesowym, transparentną komunikacją i kontrolą jakości.
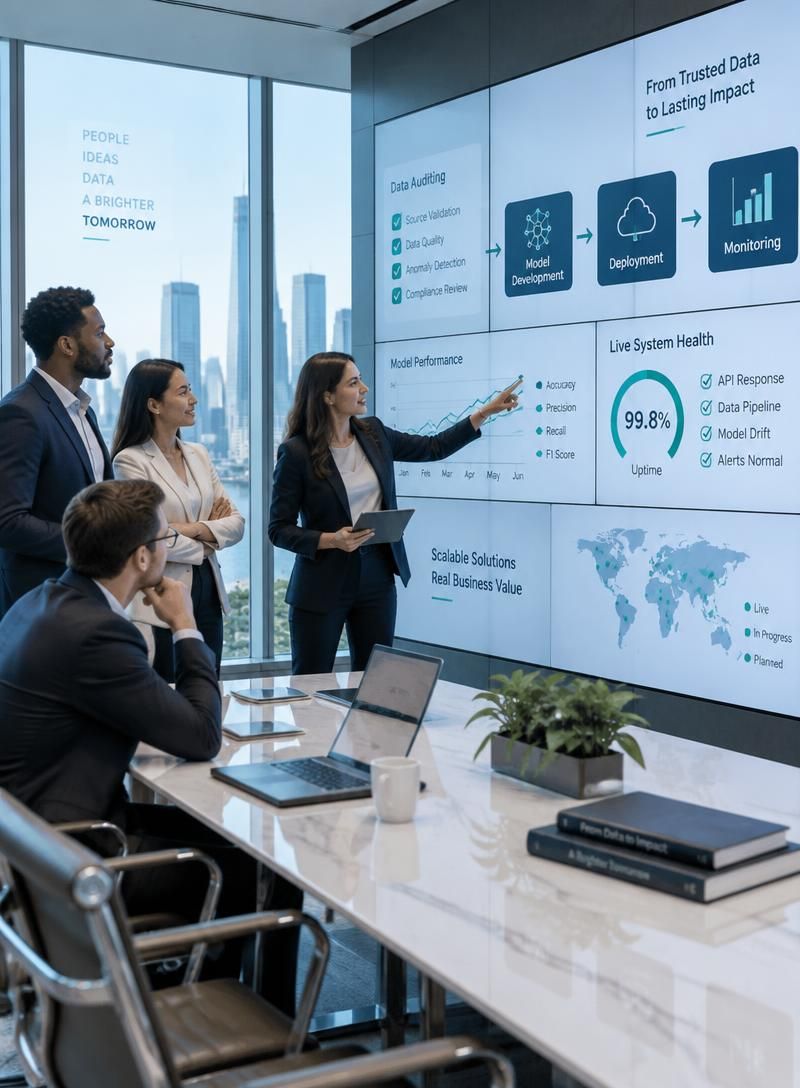
Jak przebiega współpraca — krok po kroku
Pracujemy iteracyjnie: regularnie weryfikujemy założenia, prezentujemy wyniki i dostosowujemy kolejne działania do potrzeb biznesu oraz jakości dostępnych danych.
1
Konsultacja i discovery
Poznanie kontekstu biznesowego, użytkowników rozwiązania, źródeł danych i oczekiwanych rezultatów. Ustalamy priorytety oraz wstępny plan działania.
2
Audyt danych
Oceniamy kompletność, jakość, dostępność i przydatność danych. Identyfikujemy luki, błędy, ryzyka oraz możliwości integracji informacji z różnych systemów.
3
KPI i przygotowanie danych
Definiujemy mierniki sukcesu i kryteria akceptacji, a następnie integrujemy, oczyszczamy i transformujemy dane, aby były gotowe do analizy.
4
Analiza, modelowanie, wdrożenie i monitoring
Badamy wzorce i hipotezy, budujemy oraz walidujemy modele, wdrażamy je produkcyjnie i monitorujemy ich jakość, skuteczność oraz potrzebę dalszego uczenia.
Discovery: od problemu biznesowego do precyzyjnego planu analitycznego
Dobry projekt Data Science nie zaczyna się od wyboru algorytmu, lecz od właściwego zrozumienia decyzji, którą dane mają wspierać. Podczas konsultacji przekładamy ogólne wyzwania — takie jak spadek retencji, niepewna prognoza popytu czy długi czas obsługi klienta — na jasno określone cele analityczne, pytania badawcze i możliwe scenariusze działania.
Cele i hipotezy, które można zweryfikować
Wspólnie formułujemy hipotezy oraz określamy, jakie dane i analizy pozwolą je potwierdzić lub odrzucić. Dzięki temu zespół biznesowy i techniczny pracują według tych samych założeń, a projekt skupia się na problemach o realnej wartości operacyjnej.
Mierniki sukcesu i kryteria decyzji
Ustalamy KPI biznesowe i metryki techniczne, które pozwalają rzetelnie ocenić efekty. Określamy także punkt odniesienia, oczekiwany poziom poprawy oraz sposób wykorzystania wyników w codziennych decyzjach.
Zakres, ryzyka i kolejne kroki
Rezultatem discovery jest uporządkowany zakres projektu: dostępne źródła danych, priorytetowe przypadki użycia, wymagania wdrożeniowe, ryzyka oraz harmonogram kolejnych iteracji. To podstawa transparentnej współpracy i świadomego inwestowania w analitykę oraz AI.
Dane gotowe na trafne decyzje
Ocena jakości i kompletności
Weryfikujemy poprawność, spójność, aktualność i kompletność danych, aby określić ich rzeczywistą wartość dla celów biznesowych.
Integracja źródeł danych
Łączymy dane z CRM, ERP, analityki internetowej, mediów społecznościowych i innych systemów w jeden wiarygodny ekosystem.
Czyszczenie i standaryzacja
Usuwamy duplikaty i błędy, uzupełniamy braki oraz ujednolicamy formaty, tworząc solidną bazę do dalszej analizy.
Hurtownia danych lub Data Lake
Projektujemy skalowalną architekturę przechowywania danych, dopasowaną do potrzeb raportowania, analityki i modeli AI.
Od danych do sprawdzonych hipotez
Step 1
Poznajemy dane i kontekst
Analizujemy strukturę zbiorów, dostępne wskaźniki oraz cele biznesowe, aby precyzyjnie określić pytania wymagające odpowiedzi.
Step 2
Szukamy wzorców i anomalii
Wykorzystujemy statystykę, wizualizacje i analizę zależności, aby odkryć trendy, segmenty, korelacje oraz potencjalne problemy w danych.
Step 3
Testujemy hipotezy iteracyjnie
Przekazujemy zrozumiałe wnioski w krótkich cyklach, wspólnie weryfikujemy ich wartość biznesową i dopiero potem kierujemy prace do modelowania.
Zaawansowana analityka dopasowana do celu
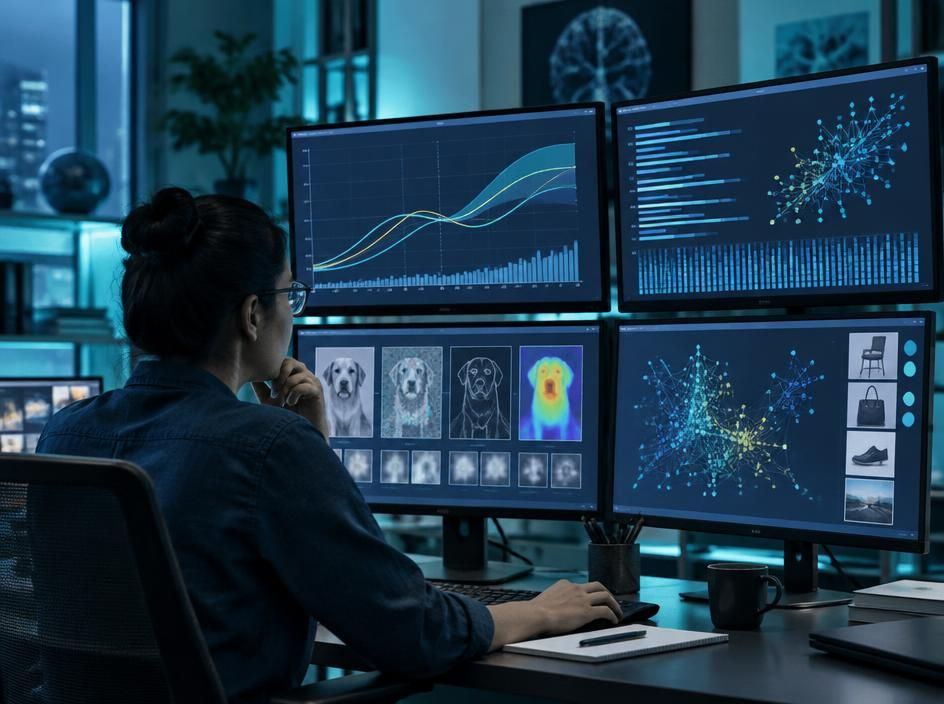
Analityka predykcyjna
Budujemy modele prognozujące popyt, ryzyko odejścia klientów, awarie urządzeń, sprzedaż i inne zdarzenia istotne dla biznesu.
NLP i prywatne rozwiązania LLM
Automatyzujemy pracę z tekstem, analizę sentymentu i obsługę wiedzy firmowej, wdrażając bezpieczne modele językowe w prywatnej infrastrukturze.
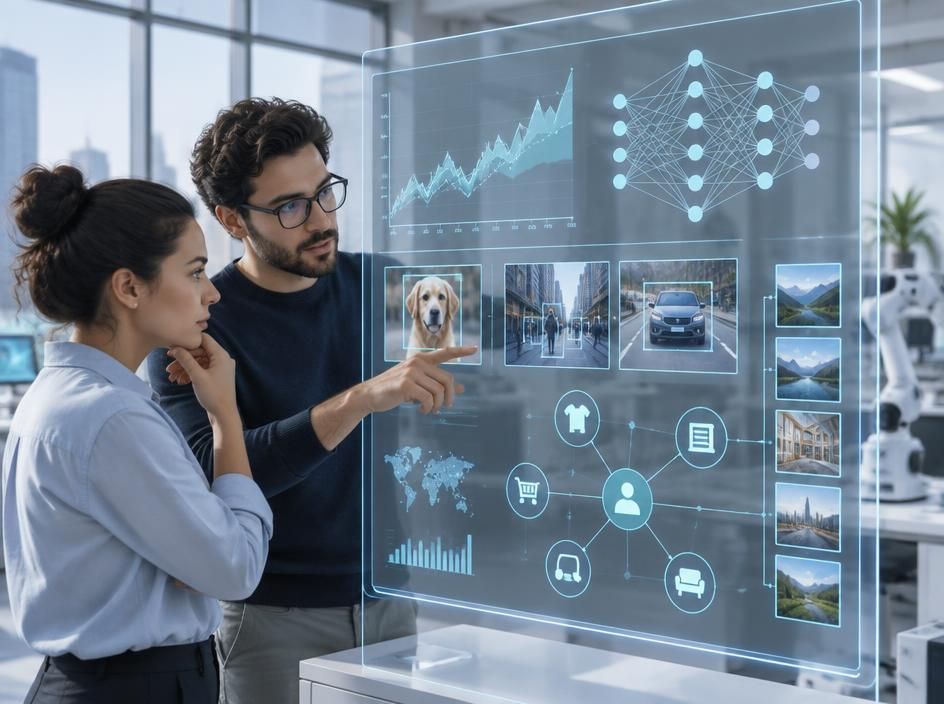
Computer Vision i rekomendacje
Tworzymy systemy rozpoznawania obrazu oraz mechanizmy rekomendacyjne, które pomagają automatyzować procesy i personalizować ofertę.
Od eksperymentu do rozwiązania produkcyjnego
Dobieramy zakres walidacji, standard techniczny i tempo prac do poziomu ryzyka oraz gotowości biznesowej projektu.
Podejście eksperymentalne
Szybka weryfikacja hipotezy na ograniczonym zakresie danych i jasno zdefiniowanym pytaniu biznesowym.
- Walidacja hipotezy55%
- Jakość techniczna45%
- Kontrola ryzyka60%
- Skalowalność30%
- Gotowość biznesowa40%
Podejście produkcyjne
Kompletne, skalowalne rozwiązanie zautomatyzowane, monitorowane i gotowe do działania w procesach biznesowych.
- Walidacja na danych rzeczywistych95%
- Jakość techniczna i testy95%
- Kontrola ryzyka90%
- Skalowalność architektury95%
- Gotowość do użycia biznesowego100%
Jakość projektu widoczna w liczbach
Każdy etap mierzymy wspólnie ustalonymi kryteriami: od kondycji danych po wpływ rozwiązania na KPI biznesowe.
Trafność modelu
Kompletność danych
Stabilność wyników
Realizacja uzgodnionych KPI
Rytm współpracy, który prowadzi do decyzji
Łączymy regularne konsultacje z krótkimi iteracjami, aby wyniki analityczne stale odpowiadały aktualnym priorytetom biznesowym.
2021
Start od konsultacji i audytów danych
Rozpoczęliśmy od projektów discovery, porządkując dane źródłowe i zamieniając nieprecyzyjne potrzeby w mierzalne cele analityczne.
2022
Krótkie iteracje i regularne przeglądy
Wprowadziliśmy rytm pracy oparty na cyklicznych konsultacjach, demonstracjach rezultatów oraz wspólnych decyzjach o następnym kroku.
2023
Rozwój wdrożeń ML i MLOps
Rozszerzyliśmy proces o automatyzację wdrożeń, testy jakości oraz monitoring modeli, aby wyniki pozostawały stabilne po uruchomieniu.
2024
Transparentna współpraca od danych do AI
Łączymy inżynierię danych, analitykę, Machine Learning i rozwiązania LLM w przejrzysty proces z jasną odpowiedzialnością i raportowaniem postępu.
Walidacja, która łączy liczby z rzeczywistością operacyjną
Model gotowy do działania, nie tylko do prezentacji
Wysoka trafność statystyczna nie jest jeszcze dowodem, że model sprawdzi się w organizacji. Walidacja techniczna weryfikuje jakość danych, stabilność wyników, odporność na błędy oraz poprawność działania w różnych scenariuszach. Sprawdzamy m.in. ryzyko przeuczenia, dryft danych, jakość predykcji na danych niewykorzystanych podczas uczenia i wydajność rozwiązania w warunkach zbliżonych do produkcyjnych.
Równolegle prowadzimy walidację biznesową z osobami, które będą korzystać z wyników modelu. Konfrontujemy rekomendacje z realnymi procesami, ograniczeniami operacyjnymi, definicjami KPI i decyzjami, które mają zostać podjęte. Dzięki temu model nie tylko poprawnie przewiduje, lecz także dostarcza wyników we właściwym czasie, w zrozumiałej formie i z korzyścią dla celu biznesowego. Transparentne kryteria akceptacji oraz iteracyjne testy pozwalają wykryć rozbieżności przed wdrożeniem, a nie po nim.
Od prototypu analitycznego do skalowalnego rozwiązania produkcyjnego
MLOps i wdrożenie produkcyjne
Client
Klient: organizacja rozwijająca procesy decyzyjne oparte na danych
Date
Etap: wdrożenie po akceptacji prototypu
My Role
Integracja, automatyzacja i skalowanie
Project Overview
Po potwierdzeniu wartości biznesowej prototypu przygotowujemy model do pracy w środowisku produkcyjnym. Integrujemy go z istniejącą infrastrukturą, aplikacjami, hurtownią danych oraz systemami źródłowymi, wykorzystując API, procesy wsadowe lub przetwarzanie strumieniowe — zależnie od wymagań procesu. Projektujemy automatyczne pipeline’y pobierania, walidacji, transformacji i dostarczania danych, tak aby wyniki modelu były aktualne, powtarzalne i dostępne we właściwym miejscu.
Budujemy również mechanizmy wersjonowania danych i modeli, testów, automatycznego wdrażania oraz douczania na nowych obserwacjach. Monitorowanie jakości danych, skuteczności predykcji, czasu odpowiedzi i dryftu modelu pozwala szybko reagować na zmiany. Całość przygotowujemy z myślą o bezpieczeństwie, niezawodności oraz skalowaniu obciążenia, dzięki czemu rozwiązanie może rosnąć wraz z liczbą użytkowników, źródeł danych i zastosowań biznesowych.
Najczęściej zadawane pytania o proces współpracy
Ile trwa realizacja projektu data science lub AI?
Czas zależy od dostępności danych, złożoności problemu, liczby integracji i wymagań wdrożeniowych. Discovery i wstępny audyt zwykle pozwalają szybko ocenić wykonalność, natomiast budowa oraz walidacja rozwiązania przebiegają iteracyjnie. Na początku ustalamy plan etapów, kamienie milowe i kryteria odbioru, aby postęp był transparentny.
Jakie dane są potrzebne, aby rozpocząć projekt?
Na start potrzebujemy informacji o celu biznesowym, dostępnych źródłach danych, ich właścicielach oraz sposobie wykorzystania wyników. Mogą to być dane z CRM, ERP, systemów transakcyjnych, analityki internetowej, plików, tekstów, obrazów lub danych z urządzeń. W audycie oceniamy ich kompletność, aktualność, jakość i przydatność do postawionego pytania.
Co dzieje się, gdy dane są niepełne lub niskiej jakości?
Najpierw identyfikujemy braki, duplikaty, niespójności i błędy pomiaru oraz oceniamy ich wpływ na KPI i wyniki modelu. Następnie proponujemy działania: czyszczenie i standaryzację danych, uzupełnianie braków, łączenie źródeł, zmianę definicji wskaźników albo plan pozyskania dodatkowych danych. Nie ukrywamy ograniczeń — jasno wskazujemy, co można wiarygodnie zbudować na obecnym materiale.
Jak wygląda współpraca podczas kolejnych etapów?
Pracujemy w krótkich, jasno komunikowanych iteracjach. Wspólnie potwierdzamy cel, KPI, zakres danych i kryteria sukcesu, a następnie regularnie prezentujemy wnioski, prototypy oraz wyniki walidacji. Po stronie biznesowej potrzebujemy dostępu do wiedzy domenowej i sprawnych decyzji, a po naszej stronie zapewniamy realizację analityczną, techniczną oraz czytelną dokumentację.
Kto odpowiada za wyniki i decyzje podejmowane na podstawie modelu?
Odpowiadamy za rzetelne przygotowanie rozwiązania, poprawność procesu analitycznego, testy techniczne i transparentne przedstawienie ograniczeń modelu. Właściciel biznesowy odpowiada za akceptację celów, zasad wykorzystania predykcji oraz decyzje operacyjne. Taki podział odpowiedzialności zapewnia, że model wspiera ludzi i procesy, zamiast zastępować nieustalone reguły biznesowe.
Jak zapewniacie bezpieczeństwo danych?
Zakres dostępu, sposób przetwarzania i miejsce przechowywania danych ustalamy przed rozpoczęciem prac. Stosujemy zasadę minimalnych uprawnień, kontrolę dostępu, bezpieczne kanały wymiany danych oraz — gdy to zasadne — pseudonimizację lub anonimizację. Rozwiązanie projektujemy zgodnie z wymaganiami środowiska klienta i obowiązującymi zasadami ochrony danych.
Czy model można zintegrować z naszymi obecnymi systemami?
Tak. Przed wdrożeniem analizujemy architekturę, dostępne interfejsy, częstotliwość aktualizacji danych i wymagania dotyczące czasu odpowiedzi. Model może działać jako usługa API, element procesu ETL/ELT, zadanie cykliczne lub komponent istniejącej aplikacji. Dobieramy sposób integracji do realnego procesu, a nie odwrotnie.
Czy model będzie wymagał późniejszego douczania?
W wielu przypadkach tak, ponieważ zmieniają się dane, zachowania użytkowników i warunki rynkowe. Ustalamy, kiedy retrening ma sens, jakie progi jakości powinny uruchamiać działanie i kto zatwierdza nową wersję modelu. Automatyzacja pipeline’ów oraz monitoring pozwalają aktualizować rozwiązanie kontrolowanie, bez utraty jakości i audytowalności.
Jak mierzycie, czy wdrożenie przynosi wartość biznesową?
Już na etapie discovery przekładamy cel biznesowy na mierzalne KPI oraz wskaźniki techniczne. Po wdrożeniu porównujemy wyniki z ustalonym punktem odniesienia, obserwujemy wykorzystanie rozwiązania i analizujemy wpływ na proces — na przykład wzrost konwersji, ograniczenie kosztów, skrócenie czasu obsługi czy poprawę trafności decyzji. Raportowanie jest zrozumiałe zarówno dla zespołów technicznych, jak i decydentów.
Zacznijmy od rozmowy o Twoich danych
Wspólnie określimy problem biznesowy, ocenimy potencjał dostępnych danych i zaplanujemy pierwszy, konkretny etap projektu — z jasnym zakresem, KPI i oczekiwanym rezultatem.