Technologie dla danych, które wspierają decyzje
Solidny stos technologiczny dla Data Science, ML i AI
Łączymy chmurę, inżynierię danych, analitykę Python, machine learning i narzędzia BI w rozwiązania, które przetwarzają dane w mierzalną wartość biznesową.
Technologia dobrana do celu, nie odwrotnie
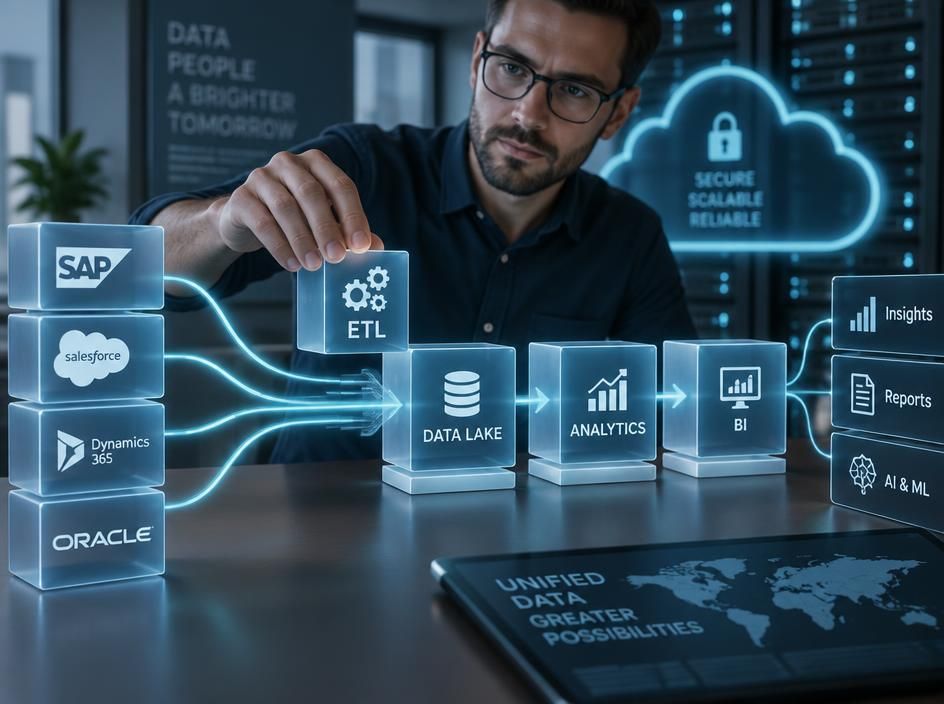
Nie zaczynamy od listy narzędzi. Najpierw określamy cel biznesowy, dostępność i charakter danych oraz oczekiwany efekt: szybsze raportowanie, prognozowanie popytu, automatyzację procesów czy wdrożenie AI. Dopiero potem projektujemy architekturę obejmującą integracje ETL/ELT, hurtownię danych lub data lake, warstwę analityczną i sposób prezentacji wyników.
Dobór platformy uwzględnia skalowalność, bezpieczeństwo, wymagania regulacyjne, koszty utrzymania oraz czas potrzebny na uruchomienie rozwiązania. Dzięki temu AWS, Azure, Snowflake, Python, narzędzia MLOps czy Power BI stają się elementami spójnego środowiska, które można rozwijać wraz z potrzebami organizacji.
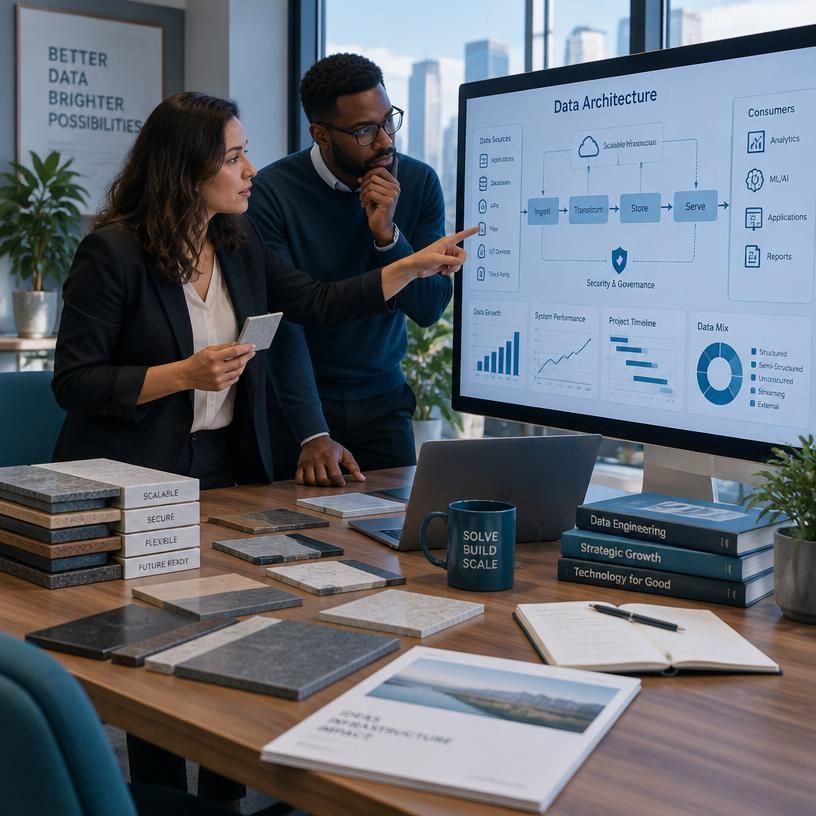
Chmura jako fundament skalowalnej pracy z danymi
AWS dla platform danych
Projektujemy środowiska AWS do bezpiecznego gromadzenia, przetwarzania i udostępniania danych. Budujemy data lake’i, pipeline’y ETL/ELT oraz warstwy analityczne, które skalują się wraz z liczbą źródeł, użytkowników i zapytań.
Azure dla analityki przedsiębiorstwa
Wykorzystujemy Azure do integracji danych z systemów biznesowych, tworzenia hurtowni i środowisk raportowych oraz uruchamiania rozwiązań AI. Architektura wspiera kontrolę dostępu, monitoring, zgodność i sprawną współpracę zespołów.
Bezpieczne środowiska data lake i analytics
Tworzymy uporządkowane ekosystemy danych z podziałem na strefy, automatyzacją przepływów i mechanizmami zarządzania jakością. Dzięki temu dane są łatwiejsze do odnalezienia, wiarygodne dla analityków i gotowe do wykorzystania w BI oraz modelach ML.
Od danych źródłowych do gotowej warstwy analitycznej
Projektujemy spójny przepływ danych, który łączy informacje operacyjne i marketingowe w wiarygodne źródło wiedzy dla raportowania, analityki oraz modeli AI.
1
Integracja źródeł danych
Pobieramy dane z CRM, ERP, Google Analytics, platform reklamowych i mediów społecznościowych, dobierając bezpieczne konektory, API oraz harmonogramy odświeżania.
2
ETL i ELT pod kontrolą
Automatyzujemy ekstrakcję, walidację i transformację danych. Usuwamy duplikaty, ujednolicamy formaty oraz łączymy rekordy w spójne procesy ETL lub ELT.
3
Warstwa surowa i uporządkowana
Zachowujemy dane źródłowe, a następnie budujemy oczyszczone warstwy pośrednie z jasno określonymi regułami jakości, historią zmian i pełną identyfikowalnością.
4
Modele analityczne gotowe do użycia
Tworzymy biznesowe warstwy danych i zestawy tematyczne, przygotowane do dashboardów BI, analiz ad hoc, prognozowania oraz zasilania modeli machine learning.
Hurtownia danych, która przyspiesza decyzje
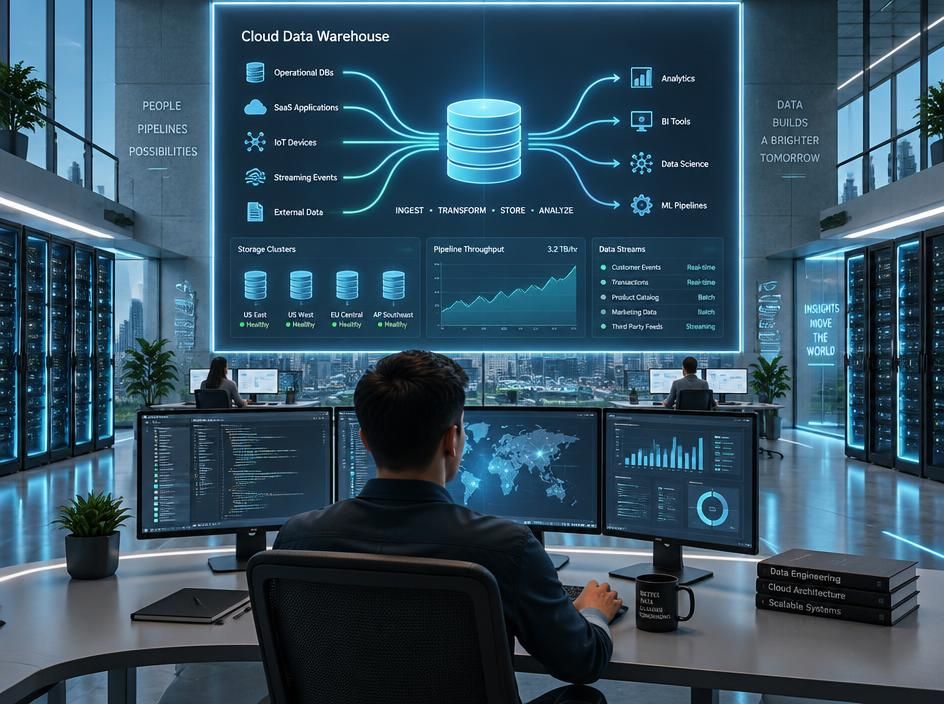
Jedno centralne źródło danych
Hurtownia łączy dane z kluczowych systemów firmy w spójnej architekturze, dzięki czemu zespoły pracują na tych samych definicjach KPI i aktualnych danych.
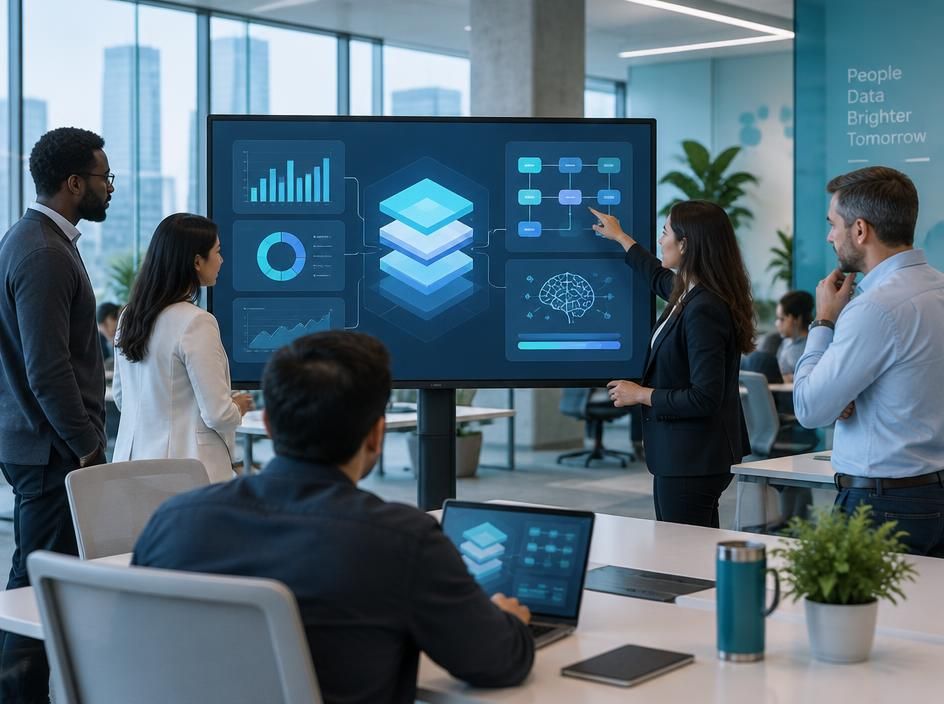
Snowflake dla wydajnej analityki
Snowflake oddziela zasoby obliczeniowe od przechowywania danych, umożliwiając szybkie skalowanie zapytań, równoległą pracę zespołów i sprawne raportowanie.
Dane przygotowane pod BI i AI
Projektujemy modele danych gotowe dla Power BI, Tableau i Looker Studio, a także zestawy cech oraz dane treningowe dla zaawansowanej analityki i modeli AI.
Jak Python zamienia dane w mierzalne wnioski
1
Czyszczenie i przygotowanie danych
2
Eksploracja oraz testowanie hipotez
3
Modelowanie i automatyzacja
Machine Learning w praktyce biznesowej
Analityka predykcyjna i personalizacja
Client
Klient z branży handlowo-produkcyjnej
Date
Realizacja ciągła
My Role
Machine Learning
Project Overview
Projektujemy modele ML, które wspierają codzienne decyzje operacyjne i handlowe. Prognozowanie popytu pomaga planować zapasy oraz ograniczać braki i nadwyżki magazynowe. Predictive maintenance pozwala przewidywać awarie urządzeń, zanim spowodują kosztowne przestoje. Modele wykrywania anomalii identyfikują nietypowe transakcje, odchylenia procesowe i sygnały ryzyka w czasie zbliżonym do rzeczywistego. Segmentacja klientów umożliwia precyzyjniejsze kampanie, a systemy rekomendacyjne podpowiadają produkty i usługi dopasowane do potrzeb użytkowników. Każde rozwiązanie łączymy z przygotowaniem danych, mierzalnymi KPI oraz wdrożeniem gotowym do działania w środowisku produkcyjnym.
NLP i Computer Vision — zastosowania dopasowane do danych
Obszar analizy
NLP — język i rozmowa
Computer Vision — obraz i wideo
Praktyczny efekt
Źródła danych
Opinie, e-maile, czaty i nagrania
Zdjęcia, skany, monitoring i transmisje
Automatyczne wykorzystanie danych nieustrukturyzowanych
Automatyzacja obsługi
Analiza opinii, chatboty i voiceboty
Rozpoznawanie obiektów oraz kontrola wizualna
Szybsza obsługa klientów i procesów operacyjnych
Wnioski biznesowe
Sentyment, intencje, tematy i jakość rozmów
Obecność obiektów, wady, ruch i zdarzenia
Czytelne alerty, decyzje i raportowanie w BI
Od eksperymentu do stale uczącego się modelu
Skuteczne MLOps łączy pracę analityczną, inżynierię danych i utrzymanie produkcyjne. Model nie kończy swojego życia po wdrożeniu — jest regularnie oceniany, monitorowany i aktualizowany wraz ze zmianą danych oraz potrzeb biznesu.
Etap 1
Eksperyment i przygotowanie danych
Definiujemy cel biznesowy i KPI, integrujemy źródła danych oraz budujemy pierwsze cechy i modele referencyjne. Porównujemy podejścia, aby wybrać rozwiązanie uzasadnione jakością oraz kosztem działania.
Etap 2
Walidacja modelu
Sprawdzamy wyniki na danych niewidzianych podczas uczenia, analizujemy błędy i odporność modelu na różne scenariusze. Ustalamy progi jakości, które model musi spełnić przed publikacją.
Etap 3
Wdrożenie produkcyjne
Pakujemy model w powtarzalny proces wdrożeniowy i udostępniamy go przez API, harmonogram lub integrację z aplikacją biznesową. Zapewniamy wersjonowanie danych, kodu i artefaktów modelu.
Etap 4
Monitorowanie jakości
Śledzimy dostępność usługi, czas odpowiedzi, jakość predykcji oraz zgodność bieżących danych z danymi treningowymi. Alerty pozwalają szybko wykryć spadek skuteczności lub problemy operacyjne.
Etap 5
Reagowanie na zmianę danych
Wykrywamy data drift i concept drift, czyli sytuacje, w których zmienia się struktura danych lub relacja między danymi a wynikiem. Analizujemy wpływ zmian na decyzje i uruchamiamy działania naprawcze.
Etap 6
Automatyczne douczanie
Po spełnieniu zdefiniowanych warunków pipeline pobiera nowe dane, ponownie trenuje model i waliduje jego wyniki. Do produkcji trafia wyłącznie wersja, która przechodzi kontrolę jakości i poprawia ustalone wskaźniki.
MLOps: model gotowy na produkcję
Powtarzalne wdrożenia, pełna kontrola i ciągła ocena modeli
MLOps łączy praktyki inżynierii danych, tworzenia oprogramowania i uczenia maszynowego, aby modele działały w produkcji równie pewnie, jak podczas eksperymentów. Automatyzujemy ścieżkę od przygotowania danych i treningu po wdrożenie, dzięki czemu kolejne wersje rozwiązania są powtarzalne, testowalne i łatwe do odtworzenia.
Kontrola wersji obejmuje kod, dane, cechy, parametry eksperymentów oraz artefakty modelu. Pozwala to prześledzić każdą decyzję, porównać wyniki i bezpiecznie przywrócić sprawdzoną wersję, gdy zmieniają się warunki biznesowe lub jakość danych. Stabilne środowiska, infrastruktura jako kod i zautomatyzowane testy ograniczają ryzyko błędów przy przenoszeniu rozwiązania między etapami pracy.
Obserwowalność modelu nie kończy się na statusie usługi. Monitorujemy jakość predykcji, dryf danych i modelu, opóźnienia, wykorzystanie zasobów oraz kluczowe wskaźniki biznesowe. Regularna ocena skuteczności pozwala wcześnie wykrywać spadek trafności, planować ponowne uczenie i utrzymywać model jako realne wsparcie dla decyzji — a nie jednorazowy projekt analityczny.
Od wyników analityki do dashboardów, które prowadzą do decyzji
Nie Znaleziono Wyników
Nie można odnaleźć żądanej strony. Spróbuj doprecyzować wyszukiwanie lub użyj nawigacji powyżej, aby znaleźć wpis.
Dobierzmy technologię do danych i celu biznesowego
Porozmawiajmy o architekturze, która ma sens dla Twojego problemu, dostępnych danych i planu wdrożenia. Wspólnie ocenimy, kiedy postawić na chmurę, hurtownię danych, pipeline ETL/ELT, model ML czy warstwę BI — i zaprojektujemy rozwiązanie gotowe do skalowania oraz utrzymania.